


Privacy dei dati e IA: cosa succede ai documenti che le affidiamo
Usare l'IA su contratti e documenti riservati vuol dire decidere dove vanno i dati. Le strade possibili, dai modelli in locale alla pseudonimizzazione, e quanto costa ognuna.
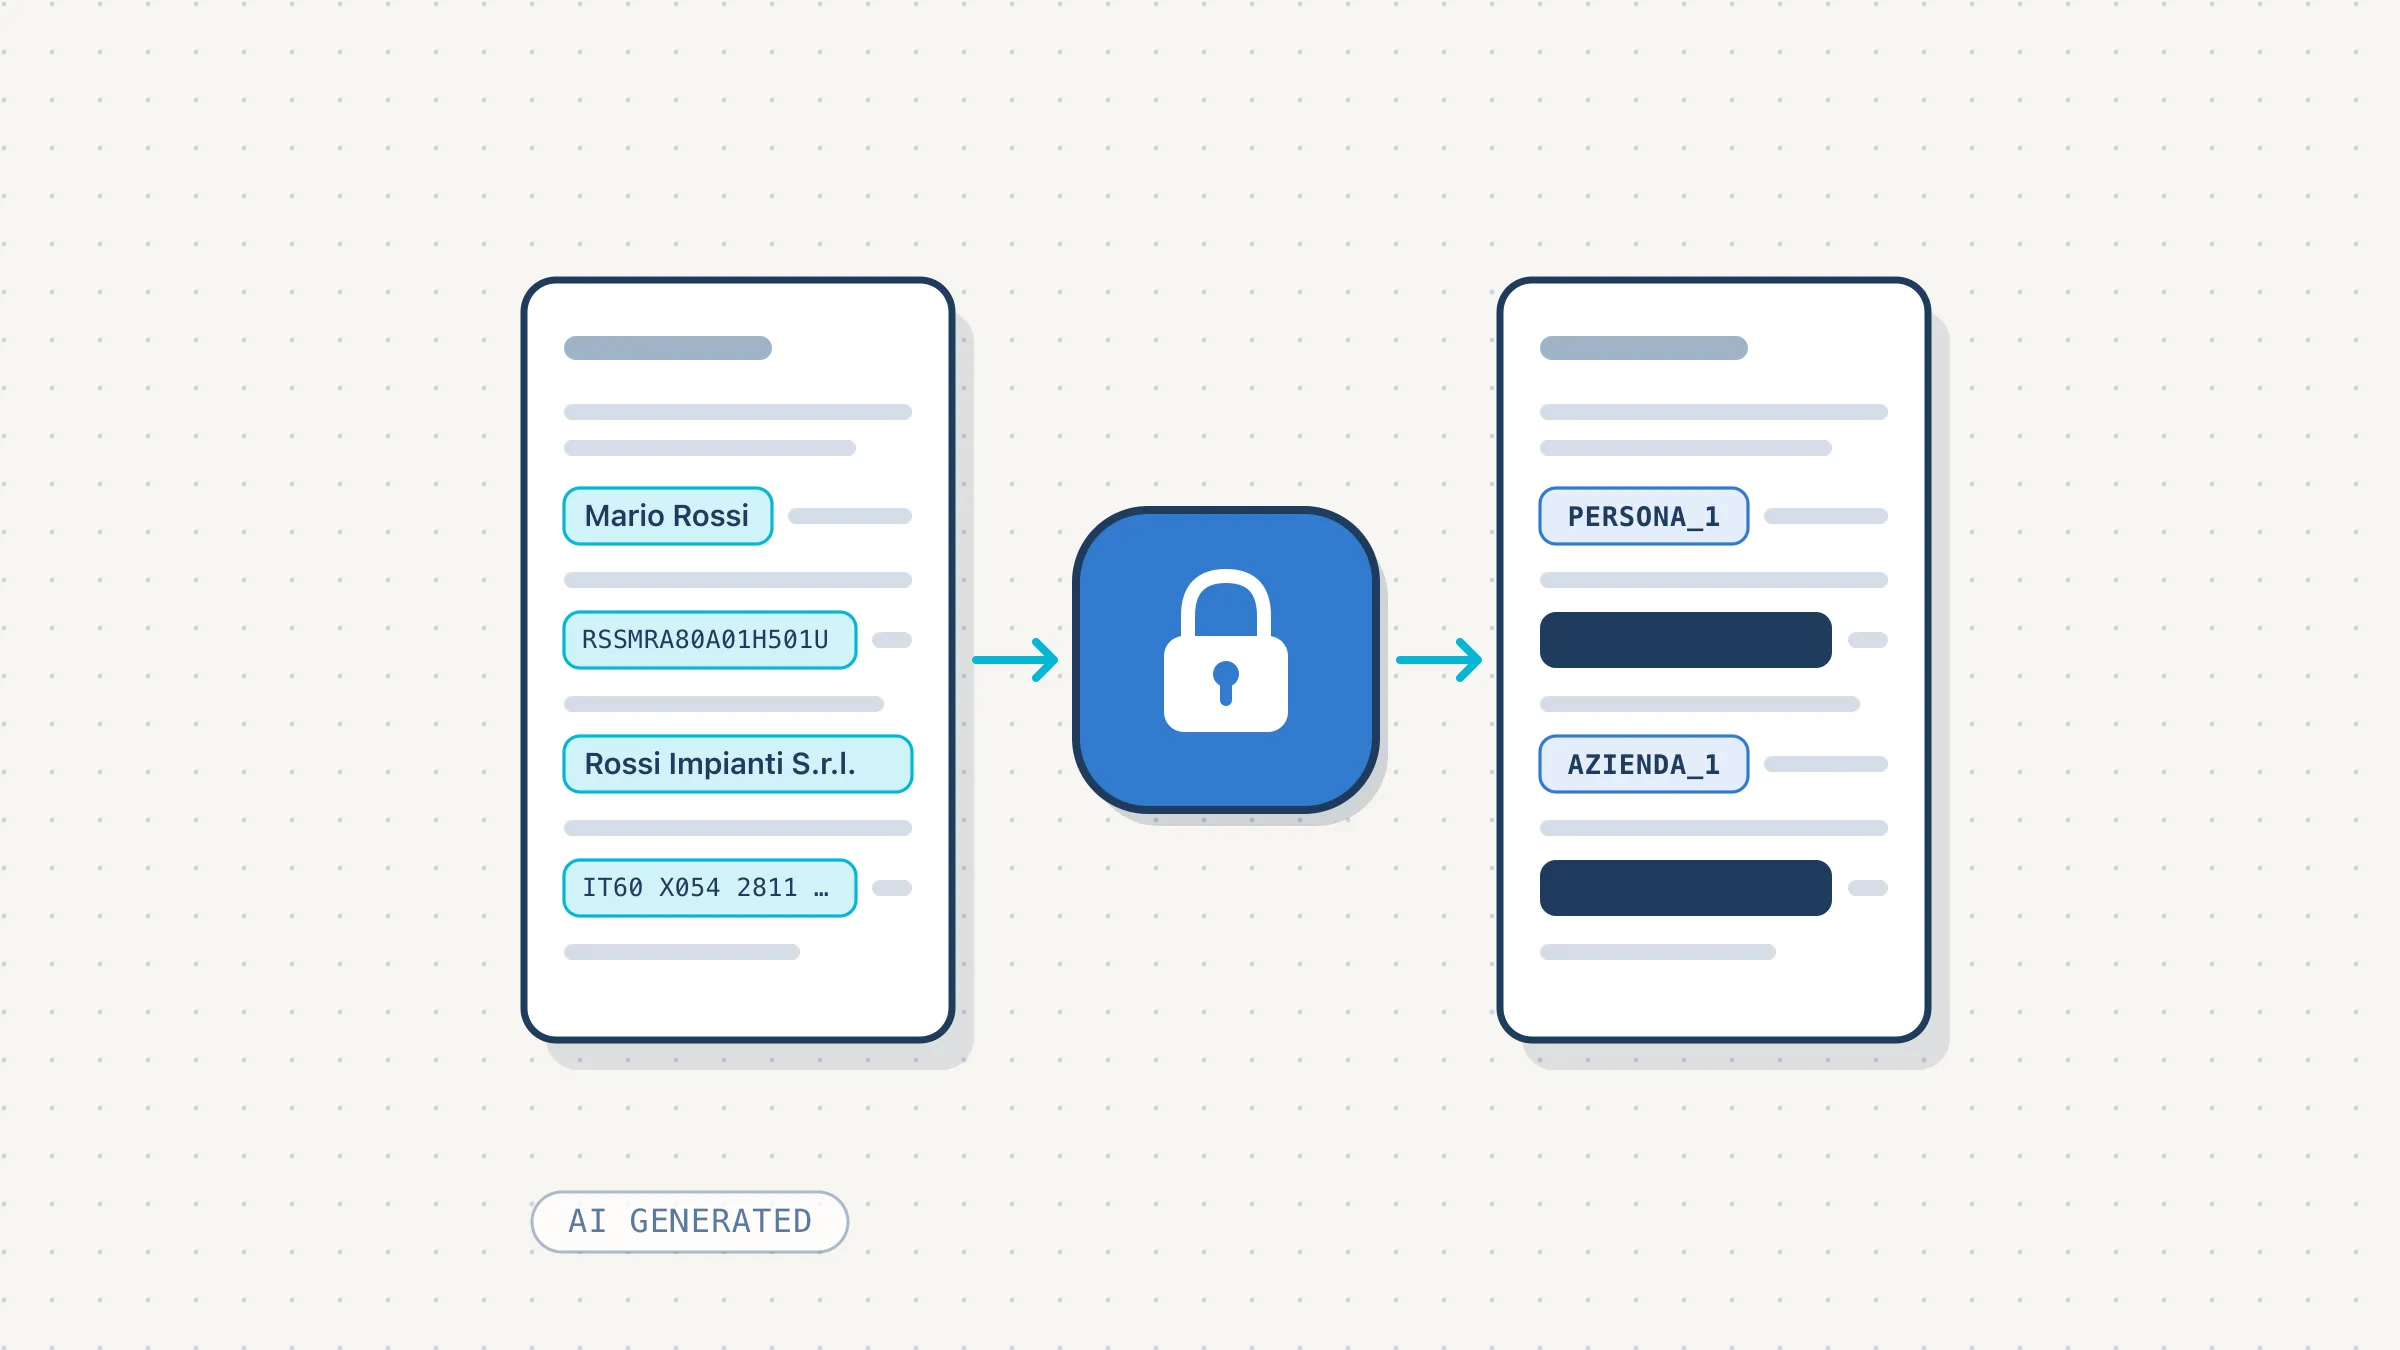
Un contratto di fornitura, una busta paga, il certificato medico di un dipendente, l’offerta riservata a un cliente. Documenti così passano ogni giorno per uno studio legale, uno studio di commercialisti o l’ufficio del personale di un’azienda. Ed è proprio su documenti così che un assistente IA fa comodo: riassume in dieci righe un contratto di quaranta pagine, trova tutte le clausole di recesso in un archivio, confronta due versioni dello stesso accordo.
Prima o poi, però, qualcuno si ferma e chiede dove finiscono quei documenti una volta caricati.
Quando la risposta non è chiara restano due strade: rinunciare, oppure usare l’IA lo stesso, magari dal proprio account personale e senza dirlo a nessuno. Con la prima si perde uno strumento utile, con la seconda i dati corrono un rischio di cui nessuno si è preso la responsabilità. Per fortuna le strade non sono solo queste due.
Cosa c’è dentro un documento
Un contratto di locazione contiene nomi e cognomi delle parti, codici fiscali, indirizzi, l’IBAN su cui versare il canone. Un fascicolo del personale può contenere certificati medici, cioè dati sulla salute, che il GDPR mette fra quelli da proteggere con più attenzione. Un’offerta commerciale magari non ha dati personali, ma ha prezzi, sconti e condizioni che un’azienda non vorrebbe mai vedere in giro.
Quando questi testi vengono incollati in un servizio di IA esterno, escono dall’organizzazione. Arrivano sui server di chi fornisce il modello, che possono trovarsi anche fuori dall’Unione europea, e lì restano per un tempo che dipende dal servizio e dal piano scelto: nei log, nella cronologia delle conversazioni, in alcuni casi fra i dati usati per addestrare i modelli successivi.
E oltre al GDPR ci sono gli obblighi di ciascuno: il segreto professionale per avvocati e commercialisti, gli accordi di riservatezza con clienti e fornitori per le aziende.
Eppure all’IA, per fare il suo lavoro, quei dati non servono quasi mai. Per trovare le clausole di recesso in un contratto non serve sapere che il locatore si chiama Mario Rossi. Serve sapere che c’è un locatore, che c’è un conduttore e chi dei due può fare cosa.
Le strade possibili, e quanto costano
Per proteggere i dati ci sono quattro strade, e nessuna è gratis: ognuna ha la sua complessità e i suoi costi. Per confrontarle prendiamo una frase come questa:
Mario Rossi (C.F. RSSMRA80A01H501U) cede a Laura Bianchi il 30% delle quote di Rossi Impianti S.r.l.
Tenere tutto in casa. Il modello gira sui server dell’organizzazione, o in un cloud che controlla lei, e i documenti non escono mai. Non serve togliere niente: la frase resta com’è e la privacy è completa. Il costo sta nell’infrastruttura, perché servono macchine adatte a far girare un modello e qualcuno che le gestisca. E i modelli più grandi e capaci, spesso, sono disponibili solo come servizio esterno.
Oscurare. Si coprono i dati, come si fa con le sentenze pubblicate:
[OMISSIS] (C.F. [OMISSIS]) cede a [OMISSIS] il 30% delle quote di [OMISSIS].
È semplice e sicuro, ma per l’IA la frase non vuol dire più niente: non si capisce chi cede e chi riceve, né se il secondo [OMISSIS] è la stessa persona del primo.
Anonimizzare. Per il GDPR vuol dire rendere impossibile risalire alla persona con mezzi ragionevoli, per chiunque, compreso chi ha fatto l’operazione. I dati davvero anonimi escono dall’ambito del regolamento, ma arrivarci è molto più difficile di quanto sembri: a volte basta un dettaglio (“l’unico socio di un’azienda di impianti di Ferrara”) per riconoscere qualcuno. E una volta anonimizzati, i dati non si possono più ricollegare alle persone, cosa che di solito serve.
Pseudonimizzare. Si sostituiscono i dati con dei segnaposto:
PERSONA_1 (C.F. CODICE_FISCALE_1) cede a PERSONA_2 il 30% delle quote di AZIENDA_1.
I dati veri finiscono in una tabella di corrispondenza conservata a parte. Il testo resta leggibile: l’IA capisce che c’è una cessione, chi cede e chi riceve, e se PERSONA_1 ricompare dieci pagine dopo sa che è la stessa persona. Alla fine chi ha la tabella rimette i nomi al loro posto. Così si possono usare anche i modelli esterni più potenti. La complessità sta nel riconoscere bene i dati da sostituire, e ci torniamo fra poco.
Il GDPR definisce la pseudonimizzazione all’articolo 4 e la cita più volte come misura da adottare quando si progetta un sistema che tratta dati personali. Su un punto però è chiaro: per chi conserva la tabella, i dati pseudonimizzati restano dati personali, perché con la tabella si torna indietro. Il rischio si riduce, gli obblighi restano.
Come si fa, in pratica
Prendiamo una mail arrivata all’ufficio acquisti di un’azienda:
Buongiorno, le scrivo per conto di Mario Rossi, titolare di Rossi Impianti S.r.l. Il sig. Rossi intende recedere dal contratto di fornitura entro il 31 marzo e chiede che il deposito cauzionale venga restituito sul conto IT60X0542811101000000123456.
Prima di mandarla a un modello esterno succedono tre cose. Si cercano nel testo i dati da proteggere: un nome, un’azienda, un IBAN. Per ognuno si decide cosa farne: l’IBAN si oscura, perché all’IA non serve, mentre nome e azienda si sostituiscono con dei segnaposto, perché servono a capire chi chiede cosa. E la sostituzione è coerente: “Mario Rossi” e “il sig. Rossi” sono la stessa persona, quindi diventano lo stesso segnaposto.
Buongiorno, le scrivo per conto di PERSONA_1, titolare di AZIENDA_1. Il sig. PERSONA_1 intende recedere dal contratto di fornitura entro il 31 marzo e chiede che il deposito cauzionale venga restituito sul conto [IBAN].
Se chiediamo al modello di riassumere la richiesta, risponde qualcosa come “PERSONA_1, titolare di AZIENDA_1, vuole recedere entro il 31 marzo e chiede la restituzione del deposito”. Prima di arrivare a chi l’ha chiesta, la risposta ripassa dalla tabella, e sullo schermo compaiono di nuovo Mario Rossi e Rossi Impianti S.r.l.
Detto così sembra un lavoro meccanico, ma ogni organizzazione ha i suoi documenti e i suoi dati da proteggere. Oltre a nomi e IBAN ci sono le matricole dei dipendenti, i codici cliente interni, i numeri di pratica, le targhe, il nome in codice di un progetto. E un contratto è scritto in modo diverso da una mail o da un referto. Per questo il riconoscimento va ottimizzato e personalizzato sui documenti di ogni cliente: si parte da un campione di documenti reali, si stabilisce cosa va protetto e come, e si verifica il risultato prima di usarlo sul serio.
Come funziona la nostra piattaforma documentale agentica
La nostra piattaforma documentale agentica risponde a domande sui documenti di un’azienda o di uno studio. Agentica vuol dire che non si limita a una ricerca: può aprire altri documenti, confrontarli, rifare la ricerca con altre parole finché non trova quello che serve per rispondere.
Dentro la piattaforma i documenti restano quelli originali e si usano in completa privacy. La piattaforma si installa in cloud oppure sui server del cliente, e il modello gira al suo interno: in questo caso i dati non escono mai e non c’è niente da anonimizzare. È la prima delle strade che abbiamo visto.
Quando un modello in locale non basta, o non si può installare, la piattaforma si collega a modelli esterni. A quel punto intercetta tutto quello che sta per uscire (la domanda, gli estratti dei documenti, i messaggi intermedi dell’agente) e lo oscura o lo pseudonimizza prima di inviarlo. La risposta torna con i segnaposto e la piattaforma rimette i dati veri prima di mostrarla. La tabella delle corrispondenze non esce mai.
Facciamo un esempio. L’ufficio acquisti chiede: “Quali contratti con Rossi Impianti scadono entro marzo e prevedono una penale per il recesso anticipato?”. L’agente cerca nell’archivio, che contiene i documenti originali, e trova sei contratti. Al modello esterno arrivano solo le clausole che servono, con AZIENDA_1 al posto del nome del fornitore. Il modello confronta date e penali e risponde, e l’ufficio acquisti legge la risposta con i nomi veri.
In sintesi
Privacy e IA possono stare insieme. Al modello non serve quasi mai sapere chi sono le persone nei documenti: gli basta sapere che sono persone diverse e che ruolo hanno. Se il modello gira in casa la privacy è completa senza toccare nulla, e se serve un modello esterno l’oscuramento e la pseudonimizzazione proteggono quello che esce. Quale strada scegliere dipende dai documenti, da dove devono restare e da quanto si vuole investire.
Se avete documenti di questo tipo e volete capire quale strada fa per voi, scriveteci: ne parliamo volentieri.