


Un PoC fatto con l'IA costa quanto una cena. Il conto arriva a fine serata
Quanto costa davvero realizzare un assistente IA sulla documentazione: i conti voce per voce, dai token alle ore di revisione, con i listini pubblici alla mano.
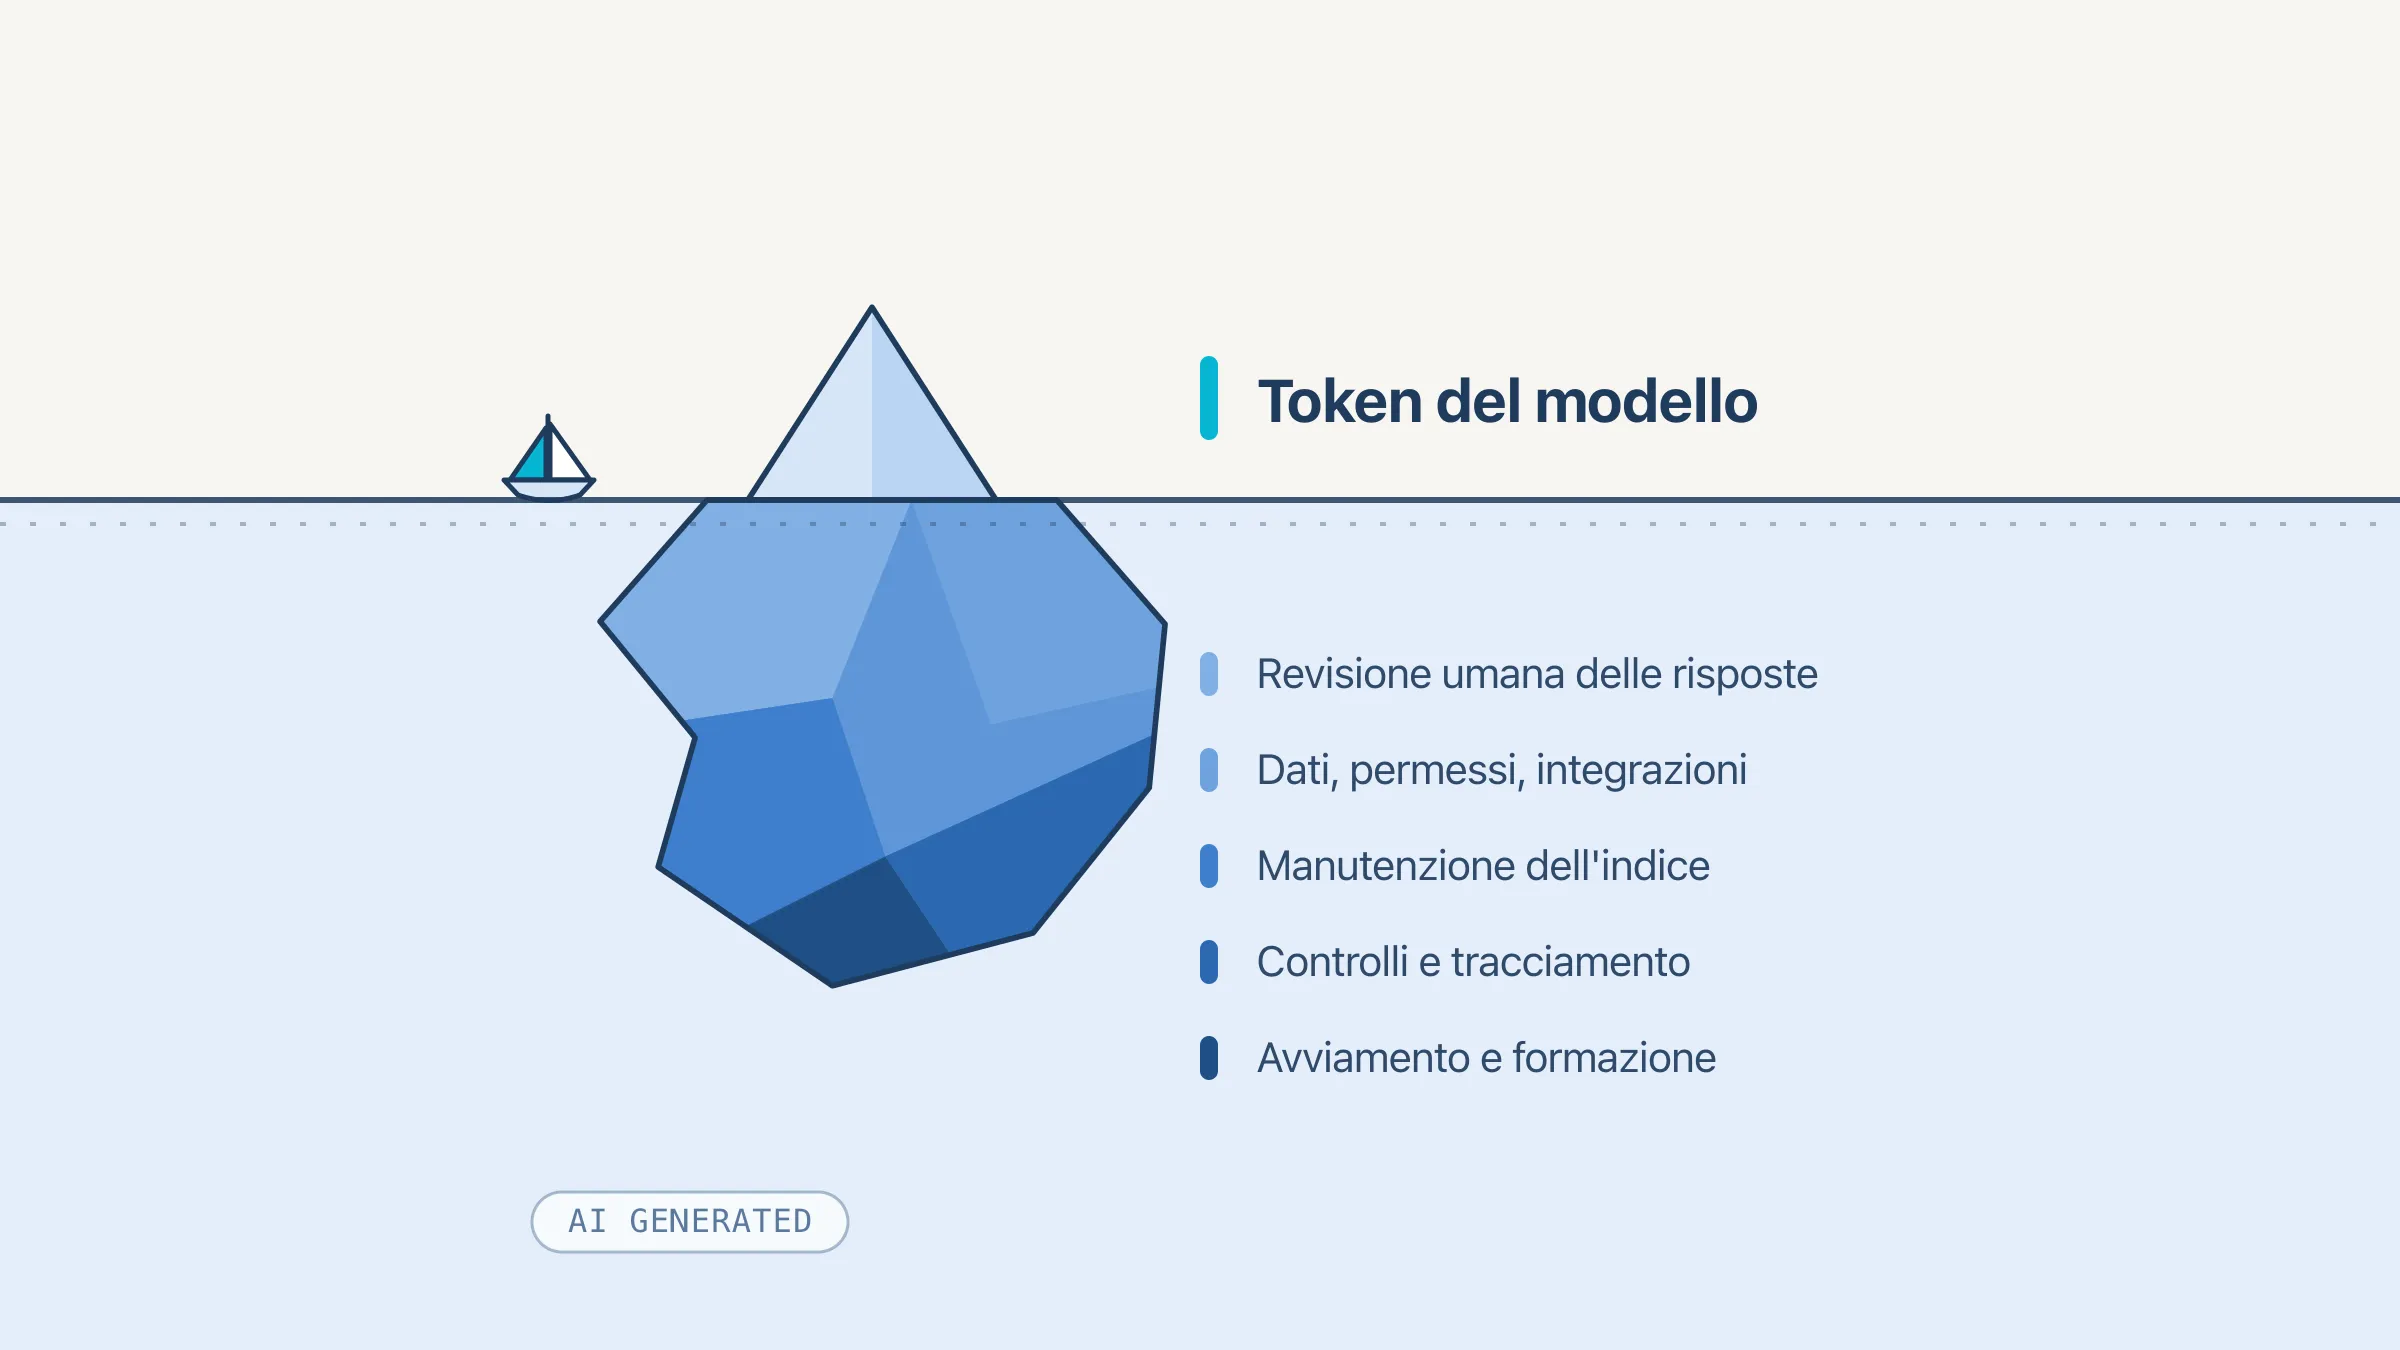
Il copione lo vedo ripetersi da un paio d’anni nelle aziende con cui lavoriamo. Qualcuno in ufficio tecnico sceglie un’IA, carica una ventina di manuali e costruisce un assistente che risponde alle domande dei manutentori. Funziona e spesso è meglio di quanto ci si aspettasse.
Poi arriva la domanda vera: quanto costa aprire il sistema a tutti in azienda?
La cosa curiosa è che a questa domanda si può rispondere con precisione, in dieci minuti, con una calcolatrice e un listino pubblico. Se restate con me lo facciamo insieme, passo passo. Il problema è che quella risposta esatta riguarda la voce di costo più piccola di tutte, ed è il motivo per cui tanti progetti superano il prototipo e si fermano sei mesi dopo.
Il caso, con i numeri sul tavolo
Prendiamo come esempio la realizzazione di un assistente sulla documentazione tecnica: manuali macchina, schemi, revisioni e così via, cioè i documenti su cui lavorano ogni giorno manutenzione e assistenza. Ipotizziamo che il sistema lo usino dieci persone, con sei domande al giorno a testa, per duecentoventi giorni lavorativi. Fanno 13.200 domande l’anno.
Ogni risposta muove più o meno questi token: 1.500 di istruzioni di sistema, otto estratti di manuale da circa 700 token l’uno, 400 token tra domanda e storico della conversazione. Sono 7.500 token in ingresso. In uscita mettiamo 600 token, cioè una risposta di una decina di righe con i riferimenti alle fonti.
Quelli che ho riportato sono valori di riferimento tipici per un sistema di questo genere: li ho scelti prendendo il centro degli intervalli che si incontrano più spesso. È chiaro che se nella vostra azienda i tecnici sono ottanta o i manuali sono più lunghi, i conti che seguono si rifanno facilmente.
Il conto dei token
I listini utilizzati sono pubblici. Prendiamo quello di Claude, a settembre 2026: Haiku 4.5, il taglio piccolo, costa 1 dollaro per milione di token in ingresso e 5 in uscita; Sonnet 5 costa 2 e 10; Opus 5, la fascia alta, costa 5 e 25. Con altri fornitori l’ordine di grandezza non cambia. I listini dei modelli sono in dollari, quindi da qui in avanti converto i totali in euro al cambio di riferimento della Banca centrale europea di settembre 2026, 1 euro per 1,16 dollari.
Per rispondere su documenti già indicizzati (sì, sto ignorando la fase di indicizzazione che si fa una sola volta, ma che ha comunque un costo) la fascia media basta, quindi partiamo da Sonnet 5: la qualità di una risposta in un archivio dipende molto più da come sono spezzati e recuperati i documenti che dalla potenza del modello. Dati i numeri visti sopra, una domanda è composta da 7.500 token in ingresso e 600 in uscita: 0,021 dollari, cioè 1,8 centesimi di euro. Moltiplicato per 13.200 domande l’anno fa 239 euro. Con Haiku 4.5 sarebbero 120, con Opus 5 598.
Venti euro al mese, per un servizio che risponde a dieci persone tutti i giorni.
Questo è l’unico numero di tutto il progetto che si può conoscere in anticipo, perché è l’unico che deriva da un listino invece che dal comportamento delle persone.
Cosa succede quando si passa a lavorare con i documenti in produzione?
Il prototipo lavora su venti manuali tipicamente puliti, magari scelti a mano da chi il prototipo lo ha costruito. La produzione lavora su quello che c’è. Rifacciamo lo stesso conto cambiando un’ipotesi alla volta.
I documenti in produzione sono più lunghi e più confusi e quindi per rispondere servono venti estratti invece di otto. L’ingresso passa da 7.500 a 15.900 token: 431 euro l’anno, quasi il doppio.
Sulle risposte che citano una procedura di sicurezza vogliamo una verifica automatica, cioè una seconda chiamata che controlla la risposta contro le fonti prima di mostrarla. Si raddoppia: 861 euro.
Poi il servizio smette di essere un assistente e diventa un agente: cerca, rilegge, confronta due revisioni del manuale, chiama il gestionale per sapere quale macchina ha davvero quel cliente, riprova quando non trova. Otto chiamate al modello per completare un’attività, con un contesto che si accumula. 2.642 euro l’anno, undici volte il punto di partenza.
E qui la scelta del modello smette di essere un dettaglio. Decidere quale documento aprire e confrontare due revisioni è il lavoro in cui la fascia alta si ripaga, mentre rispondere su un estratto già trovato no: lo stesso scenario agentico su Opus 5 costa 6.606 euro l’anno. Fra il caso di partenza e quest’ultimo, per lo stesso servizio, il costo aumenta di circa 30 volte.
Restano comunque poche migliaia di euro. Tenete a mente l’ordine di grandezza, perché nella prossima sezione serve per il confronto.
Il parametro che nessuno ha misurato
Stessa azienda, stessa telemetria, ma un’altra domanda: quante di quelle 13.200 risposte richiedono che una persona intervenga? Verificare una citazione dubbia, correggere una procedura, gestire il caso che il sistema non ha “capito”, rispondere al tecnico che ha ricevuto un’indicazione sbagliata.
Mettiamo dodici minuti a intervento e trentacinque euro l’ora di costo aziendale.
Se gli interventi sono il 5% delle risposte: 132 ore l’anno, 4.620 euro. Tre settimane di lavoro.
Se sono il 15%: 396 ore, 13.860 euro. Due mesi e mezzo di una persona, che nei conti iniziali non erano presenti (e neanche nei budget aziendali).
Dieci punti percentuali su un numero che nessuno ha misurato valgono 9.000 euro l’anno, cioè più di quanto costi il modello in qualunque scenario di questo articolo. Il prototipo non poteva mettere in luce niente di tutto questo: le domande di prova le ha scritte chi lo ha costruito, e le risposte le ha giudicate buone lui.
Questo è il vero contenuto della frase “il PoC ha funzionato”: ha funzionato su un campione scelto da chi aveva interesse a dimostrarne il funzionamento perfetto e la facilità con la quale è stato ottenuto. Attenzione, non si tratta di disonestà, è la natura stessa dei prototipi, magari realizzati dopo una progettazione iniziale un po’ sbrigativa.
Le voci che un listino non contiene
Restano fuori dai conti le cose che costano di più e che non stanno in nessun listino, perché non dipendono dal fornitore ma da come è fatta la vostra azienda.
Non vengono valutati a dovere i dati e le integrazioni necessarie, che nel nostro lavoro quotidiano di realizzazione di software industriale e acquisizione dati dalle macchine risultano quasi sempre la voce più pesante. Quante revisioni di manuale escono in un anno, e quindi quanto spesso va rifatto l’indice. Quanti formati diversi ci sono davvero, contando i PDF scansionati che nessuno ammette di avere. Chi può vedere cosa, e come lo si fa rispettare quando la ricerca semantica attraversa tutto l’archivio. Quanti sistemi vanno interrogati per dare una risposta utile, e cosa succede quando uno dei due non risponde.
I controlli, che nel prototipo non esistono per definizione: tracciare cosa è stato chiesto e cosa è stato risposto, accorgersi quando la qualità peggiora, sapere su quale versione del manuale si basava una risposta data tre mesi fa.
Non vi do delle cifre, perché sarebbero inventate, ma credo sia utile darvi le domande che servono a ricavarle, che è il lavoro da fare prima di allargare il servizio, non dopo.
L’assistente misura anche la vostra documentazione
Torniamo un momento ai venti estratti che poco fa hanno fatto raddoppiare il conto. Quel numero non dice niente sul modello, ma dice molto sui documenti. Infatti se per rispondere a una domanda servono venti pezzi invece di otto, questo significa che probabilmente la stessa informazione è sparpagliata in molti punti diversi.
Le metriche impostate per tenere sotto controllo la spesa sono anche la prima misura oggettiva che la vostra azienda abbia mai avuto sulla propria documentazione tecnica, per il semplice motivo che prima (quasi) nessuno l’aveva letta per intero.
Le domande che non trovano nessuna fonte sono i buchi, cioè informazioni che i tecnici hanno sempre chiesto a un collega perché non sono scritte da nessuna parte. Le risposte che cambiano a seconda di come si formula la domanda sono dovute alle varie revisioni che convivono contemporaneamente. Le sezioni che non vengono recuperate mai sono pagine che non servono a nessuno, ma che intanto si pagano in fase di indicizzazione e di manutenzione.
Questa non vuole essere una paternale, la documentazione invecchia in tutte le aziende, compresa la nostra. Il punto è che adesso lo si dimostra con i numeri e la conclusione spesso non è “serve un modello più potente”, ma “vanno riscritte quelle dodici procedure”. Anche quello è un costo del progetto, ma è un costo che esisteva già e che semplicemente nessuno vedeva.
Il prezzo che scende non ci salva
C’è un’obiezione ricorrente a tutto questo: “tanto i modelli costano sempre meno”. È vero ed è documentato. L’AI Index di Stanford ha misurato che interrogare un modello di qualità equivalente a GPT-3.5 sul test MMLU è passato da 20 dollari per milione di token nel novembre 2022 a 0,07 dollari nell’ottobre 2024. Duecentottanta volte in diciotto mesi.
Il punto è che nei conti qui sopra il prezzo unitario non lo abbiamo mai toccato. A cambiare sono stati il contesto, il numero di chiamate e le persone. Il costo per token può continuare a crollare: se intanto il contesto triplica e l’agente fa otto chiamate al posto di una, la spesa sale lo stesso. E la parte in euro, quella delle ore di revisione, non scende affatto.
Quello che succede agli altri
Vale la pena guardare i numeri pubblici su come vanno questi progetti, perché raccontano sempre la stessa storia.
Gartner aveva previsto nel luglio 2024 che almeno il 30% dei progetti di IA generativa sarebbe stato abbandonato dopo il prototipo entro fine 2025. A consuntivo la sua stima è salita oltre il 50%, con quattro cause ricorrenti: qualità dei dati, controlli di rischio inadeguati, costi crescenti, valore di business poco chiaro. Nessuna delle quattro è “il modello non era abbastanza bravo”. Sono le stesse voci che abbiamo elencato qui sopra e che un prototipo non misura.
La ricerca The GenAI Divide del MIT NANDA aggiunge un dato che ci riguarda da vicino: nel loro campione le iniziative costruite con un partner esterno sono arrivate in produzione circa il 67% delle volte, contro il 33% di quelle costruite internamente. Gli autori ci mettono un avvertimento che vale la pena riportare, visto che a noi quel dato farebbe comodo: la differenza può riflettere le capacità organizzative di chi sceglie un partner più che l’approccio in sé, e la correlazione non dimostra la causa. Il campione sono 52 interviste, 153 risposte a un questionario e l’analisi di oltre 300 iniziative pubbliche.
Sul mercato italiano, l’Osservatorio del Politecnico di Milano segnala che nel 2025 il 71% delle grandi imprese aveva avviato almeno un progetto di IA, contro l’8% delle PMI. Le PMI hanno un vantaggio che le grandi non hanno più: non hanno ancora fatto gli errori e possono partire misurando invece di scoprire.
Cosa misuriamo dal primo giorno
Quando mettiamo in piedi un pilota, la parte che richiede più discussione non è il modello. È decidere cosa contare e accendere il contatore prima di partire invece che dopo la prima fattura che sorprende qualcuno.
La lista minima è corta: token in ingresso e in uscita per risposta, numero di chiamate al modello per attività completata, quante risposte finiscono in revisione umana e quanto dura la revisione, quante domande non trovano una fonte, su quale versione del documento si è risposto. Più una cosa che non è telemetria ma pesa quanto tutto il resto: chi in azienda paga quel servizio e chi ne raccoglie i benefici.
Con quei numeri, dopo sei settimane di pilota vero, il costo per risposta valida non è più una stima, ma diventa una misura e il salto da dieci a cento utenti si decide su numeri concreti invece che su una dimostrazione andata bene.
Senza quei numeri il prototipo vi ha detto una cosa sola, cioè che il modello funziona, ma direi che quello ormai lo sappiamo tutti.
Se avete un prototipo sul tavolo e dovete decidere se allargarlo a tutti, scriveteci a rgb@fancypixel.it: i conti di questo articolo li rifacciamo volentieri con i vostri volumi.